■概要
データ分析・機械学習の基本となる「回帰分析」について、代表的な2つの手法である単回帰分析と重回帰分析を、最小二乗法の計算式をもとにPythonで自前実装する。
回帰分析とは、「原因側の値(説明変数)」から「結果側の値(目的変数)」を予測する式を求める手法である。今回は「勉強時間や睡眠時間から、テストの点数を予測できるか」を題材にする。
- 単回帰分析:1つの説明変数から目的変数を予測する直線
y = a × x + bを求める- a(傾き・回帰係数):x が1増えると y がどれだけ増えるか
- b(切片):x が0のときの y の値
- 最小二乗法:実際の値と予測値のズレ(残差)の2乗の合計が最小になるように a, b を決める
- 計算式:
a = Σ(x - xの平均)(y - yの平均) / Σ(x - xの平均)²、b = yの平均 - a × xの平均
- 重回帰分析:複数の説明変数から目的変数を予測する式
y = b0 + b1 × x1 + b2 × x2 + ...を求める- 行列を使った「正規方程式」
β = (XᵀX)⁻¹ Xᵀyで係数を一度に求められる - 逆行列を直接計算するより、
np.linalg.solveで連立方程式として解く方が数値計算的に安定する
- 行列を使った「正規方程式」
- 決定係数(R²):回帰式がデータをどれだけうまく説明できているかを表す指標
- 計算式:
R² = 1 - (残差の二乗和 / 全変動の二乗和) - 0〜1の範囲を取り、1に近いほど当てはまりが良い
- 説明変数を増やすと(意味のない変数でも)R² は上がりやすい点に注意
- 計算式:
■実装するサンプル処理の概要
16人分の勉強時間(study_hours)・睡眠時間(sleep_hours)・テストの点数(test_score)のサンプルデータをCSVから読み込み、次の3ステップで回帰分析を行う。
- 単回帰分析(勉強時間 → 点数)
- 最小二乗法で回帰式と決定係数を求める
numpy.polyfitの結果と一致することを確認する- 求めた回帰式で、勉強時間5.25時間のときの点数を予測する
- 重回帰分析(勉強時間 + 睡眠時間 → 点数)
- 正規方程式で回帰式と決定係数を求め、単回帰と比較する
- 実測値・予測値・残差を表にして比較する
- 可視化
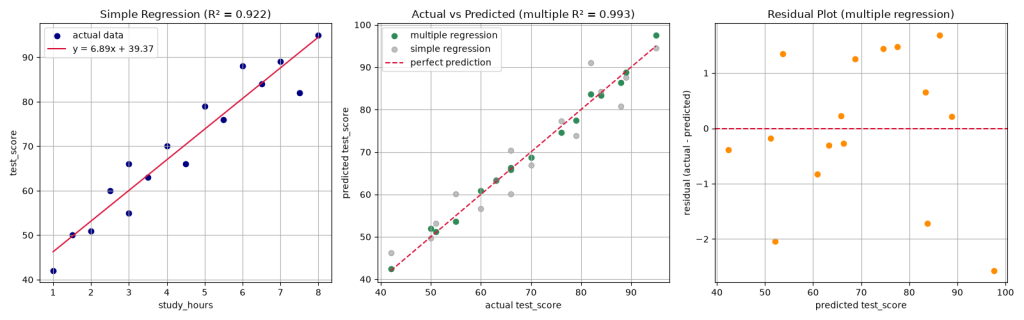
- 単回帰の散布図+回帰直線、重回帰の「実測値 vs 予測値」、重回帰の残差プロットを1つの図にまとめて描画する
■フローチャート
全体の流れ
flowchart TD
A([開始]) --> B["関数を定義 simple_linear_regression / multiple_linear_regression / r_squared"]
B --> C["CSVファイルを読み込む (regression_data.csv)"]
C --> D[元データをコンソール出力]
D --> E[["1. 単回帰分析 (勉強時間 → 点数)"]]
E --> F[["2. 重回帰分析 (勉強時間 + 睡眠時間 → 点数)"]]
F --> G[["3. 可視化 (3つのグラフを描画)"]]
G --> H([終了])
- 回帰分析で使う3つの関数(単回帰・重回帰・決定係数)を定義する
- CSV(勉強時間・睡眠時間・点数データ)を読み込み、元データを出力する
- 「単回帰分析」「重回帰分析」「可視化」の3ステップを順に実行する
1. 単回帰分析
flowchart TD
A([単回帰分析 開始]) --> B["説明変数 x = study_hours 目的変数 y = test_score を取り出す"]
B --> C["simple_linear_regression(x, y) で 傾き slope・切片 intercept を計算"]
C --> D["予測値を計算 slope × x + intercept"]
D --> E["r_squared で決定係数 R² を計算"]
E --> F[回帰式・R² をコンソール出力]
F --> G["np.polyfit(deg=1) で 同じ結果になることを確認"]
G --> H["勉強時間 5.25 時間の 点数を予測して出力"]
H --> I([単回帰分析 終了])
- 説明変数(勉強時間)と目的変数(点数)を取り出す
simple_linear_regressionで回帰直線の傾き・切片を求める- 回帰式で各データの予測値を計算し、
r_squaredで決定係数を求めて出力する numpy.polyfit(deg=1)(1次式での近似)でも同じ傾き・切片になることを確認する- 求めた回帰式で、勉強時間5.25時間のときの点数を予測する
simple_linear_regression(最小二乗法)
flowchart TD
A(["simple_linear_regression(x, y)"]) --> B[x の平均・y の平均を計算]
B --> C["分子を計算 Σ(x -- xの平均)(y -- yの平均)"]
C --> D["分母を計算 Σ(x -- xの平均)²"]
D --> E["傾き slope = 分子 / 分母"]
E --> F["切片 intercept = yの平均 -- slope × xの平均"]
F --> G([slope, intercept を返す])
- x と y の平均値を求める
- 分子(x と y が一緒にどう動くか=共分散に相当)を計算する
- 分母(x がどれだけばらついているか=分散に相当)を計算する
- 傾き=分子 / 分母、切片=yの平均 – 傾き × xの平均 を求めて返す
2. 重回帰分析
flowchart TD
A([重回帰分析 開始]) --> B["説明変数 x = study_hours, sleep_hours を取り出す"]
B --> C["multiple_linear_regression(x, y) で 係数 b0, b_study, b_sleep を計算"]
C --> D["予測値を計算 b0 + b_study × 勉強時間 + b_sleep × 睡眠時間"]
D --> E["r_squared で決定係数 R² を計算"]
E --> F["回帰式・R²(単回帰との比較)を コンソール出力"]
F --> G["実測値・単回帰予測値・重回帰予測値・残差 の比較表を作成して出力"]
G --> H([重回帰分析 終了])
- 説明変数(勉強時間・睡眠時間)を取り出す
multiple_linear_regressionで切片・各説明変数の係数を求める- 回帰式で各データの予測値を計算し、決定係数を求めて単回帰と比較する
- 実測値・単回帰の予測値・重回帰の予測値・残差を1つの表にまとめて出力する
multiple_linear_regression(正規方程式)
flowchart TD
A(["multiple_linear_regression(x, y)"]) --> B[すべて1の列を作成]
B --> C["1の列を先頭に追加して 行列 X を作成"]
C --> D[y をベクトルに変換]
D --> E["XᵀX と Xᵀy を計算"]
E --> F["np.linalg.solve で XᵀX β = Xᵀy を解く"]
F --> G(["係数 [b0, b1, b2] を返す"])
- 切片 b0 を他の係数と同じように計算するため、すべて1の列を説明変数の先頭に追加して行列 X を作る
- XᵀX と Xᵀy を計算する
np.linalg.solveで連立方程式 XᵀX β = Xᵀy を解き、係数 [b0, b1, b2] を返す
r_squared(決定係数)
flowchart TD
A(["r_squared(y_actual, y_predicted)"]) --> B["残差の二乗和を計算 Σ(実測値 -- 予測値)²"]
B --> C["全変動の二乗和を計算 Σ(実測値 -- 平均値)²"]
C --> D(["1 -- 残差の二乗和 / 全変動の二乗和 を返す"])
- 残差の二乗和(予測で説明できなかったばらつき)を計算する
- 全変動の二乗和(データ全体のばらつき)を計算する
- 1 – 残差の二乗和 / 全変動の二乗和 を返す
3. 可視化
flowchart TD
A([可視化 開始]) --> B["1行3列のグラフ領域を作成"]
B --> C["(1) 単回帰 散布図に回帰直線を重ねて描画"]
C --> D["(2) 重回帰 実測値 vs 予測値の散布図 (単回帰の予測値・y = x の線も重ねる)"]
D --> E["(3) 残差プロット 予測値ごとの残差と 0 の線を描画"]
E --> F[レイアウトを調整してグラフを表示]
F --> G([可視化 終了])
- 1行3列のグラフ領域を作成する
- 単回帰の散布図に回帰直線を重ねる(点が直線の近くに集まるほど当てはまりが良い)
- 重回帰の実測値 vs 予測値を描画する(説明変数が2つ以上だと直線では描けないため、点が対角線 y = x 上に並ぶほど予測が正確と判断する)
- 重回帰の残差プロットを描画する(残差が0の線の上下にランダムに散らばっていれば回帰モデルが妥当と判断できる)
■サンプルコード
・regression_analysis.py
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd


def simple_linear_regression(x: pd.Series, y: pd.Series) -> tuple[float, float]:
    """
    単回帰分析(最小二乗法)
    1つの説明変数 x から目的変数 y を予測する直線「y = a * x + b」を求める。

    - a:傾き(回帰係数)… x が1増えると y がどれだけ増えるか
    - b:切片 … x が0のときの y の値

    最小二乗法とは:
    実際の値 y と、直線で予測した値との「ズレ(残差)」を2乗して合計し、
    その合計が最も小さくなるように a と b を決める方法。
    (2乗するのは、プラスのズレとマイナスのズレが打ち消し合わないようにするため)

    計算式:
    - a = Σ(x - xの平均)(y - yの平均) / Σ(x - xの平均)^2
          (= xとyの共分散 / xの分散)
    - b = yの平均 - a * xの平均
    """
    x_mean = x.mean()
    y_mean = y.mean()

    # 分子:x と y が「一緒にどう動くか」を表す量(共分散に相当)
    numerator = ((x - x_mean) * (y - y_mean)).sum()
    # 分母:x が「どれだけばらついているか」を表す量(分散に相当)
    denominator = ((x - x_mean) ** 2).sum()

    slope = numerator / denominator
    intercept = y_mean - slope * x_mean
    return slope, intercept


def multiple_linear_regression(x: pd.DataFrame, y: pd.Series) -> np.ndarray:
    """
    重回帰分析(最小二乗法・正規方程式)
    複数の説明変数 x1, x2, ... から目的変数 y を予測する式
    「y = b0 + b1 * x1 + b2 * x2 + ...」の係数を求める。

    行列を使うと、最小二乗法の解は次の「正規方程式」で一度に求められる:
        β = (XᵀX)⁻¹ Xᵀy
    - X:説明変数を並べた行列(先頭列に切片用の「1」の列を追加する)
    - Xᵀ:X の転置(行と列を入れ替えた行列)
    - ⁻¹:逆行列

    戻り値:[b0(切片), b1, b2, ...] の順に並んだ係数の配列
    """
    # 切片 b0 を計算するために、すべて1の列を先頭に追加する
    # (b0 * 1 = b0 となるので、切片も他の係数と同じように計算できる)
    ones = np.ones((len(x), 1))
    x_matrix = np.hstack([ones, x.to_numpy()])
    y_vector = y.to_numpy()

    # 逆行列を直接計算する(np.linalg.inv)よりも、
    # 連立方程式として解く(np.linalg.solve)方が数値計算的に安定している
    xtx = x_matrix.T @ x_matrix
    xty = x_matrix.T @ y_vector
    return np.linalg.solve(xtx, xty)


def r_squared(y_actual: pd.Series, y_predicted: pd.Series) -> float:
    """
    決定係数(R²)
    回帰式がデータをどれだけうまく説明できているかを表す指標。

    計算式:R² = 1 - (残差の二乗和 / 全変動の二乗和)
    - 残差の二乗和:実際の値と予測値のズレの2乗の合計(予測で説明できなかった分)
    - 全変動の二乗和:実際の値と平均値のズレの2乗の合計(データ全体のばらつき)

    特徴:
    - 0〜1の範囲を取り、1に近いほど当てはまりが良い
    - 例えば R² = 0.8 なら「yのばらつきの80%を回帰式で説明できている」という意味
    - 説明変数を増やすと(意味のない変数でも)R² は上がりやすい点に注意
    """
    residual_sum_of_squares = ((y_actual - y_predicted) ** 2).sum()
    total_sum_of_squares = ((y_actual - y_actual.mean()) ** 2).sum()
    return 1 - residual_sum_of_squares / total_sum_of_squares


# CSVを読み込む
# 列:name(名前), study_hours(勉強時間h), sleep_hours(睡眠時間h), test_score(テストの点数)
# → 「勉強時間や睡眠時間から、テストの点数を予測できるか」を回帰分析で調べる
input_data = pd.read_csv('regression_data/regression_data.csv')

print('=== 元データ ===')
print(input_data)

# ------------------------------------------------------------
# 1. 単回帰分析:勉強時間 → テストの点数
# ------------------------------------------------------------
# 説明変数(原因側・予測に使う値)と目的変数(結果側・予測したい値)を取り出す
x_study = input_data['study_hours']
y_score = input_data['test_score']

slope, intercept = simple_linear_regression(x_study, y_score)

# 求めた回帰式を使って、各データの予測値を計算する
simple_predicted = slope * x_study + intercept
simple_r2 = r_squared(y_score, simple_predicted)

print('\n=== 単回帰分析(勉強時間 → 点数) ===')
print(f'回帰式:点数 = {slope:.3f} × 勉強時間 + {intercept:.3f}')
print(f'→ 勉強時間が1時間増えると、点数は約 {slope:.2f} 点上がる')
print(f'決定係数 R²:{simple_r2:.3f}')

# numpy の polyfit(多項式フィッティング)でも同じ結果になることを確認する
# deg=1 は「1次式(直線)」で近似するという意味
np_slope, np_intercept = np.polyfit(x_study, y_score, deg=1)
print(f'(確認)np.polyfit の結果:傾き = {np_slope:.3f}, 切片 = {np_intercept:.3f}')

# 求めた回帰式で、新しいデータの点数を予測してみる
# 注意:元データの範囲(1〜8時間)の外側を予測する「外挿」は信頼性が低い
# 例えば 9時間で計算すると100点を超えてしまうなど、現実にあり得ない値になることがある
new_study_hours = 5.25
print(f'予測:勉強時間 {new_study_hours} 時間 → 約 {slope * new_study_hours + intercept:.1f} 点')

# ------------------------------------------------------------
# 2. 重回帰分析:勉強時間 + 睡眠時間 → テストの点数
# ------------------------------------------------------------
feature_columns = ['study_hours', 'sleep_hours']
x_features = input_data[feature_columns]

coefficients = multiple_linear_regression(x_features, y_score)
b0, b_study, b_sleep = coefficients

# 予測値 = b0 + b1 * 勉強時間 + b2 * 睡眠時間
multiple_predicted = b0 + b_study * input_data['study_hours'] + b_sleep * input_data['sleep_hours']
multiple_r2 = r_squared(y_score, multiple_predicted)

print('\n=== 重回帰分析(勉強時間 + 睡眠時間 → 点数) ===')
print(f'回帰式:点数 = {b0:.3f} + {b_study:.3f} × 勉強時間 + {b_sleep:.3f} × 睡眠時間')
print(f'→ 睡眠時間が同じなら、勉強時間1時間で約 {b_study:.2f} 点上がる')
print(f'→ 勉強時間が同じなら、睡眠時間1時間で約 {b_sleep:.2f} 点上がる')
print(f'決定係数 R²:{multiple_r2:.3f}(単回帰:{simple_r2:.3f})')

# 実際の値・予測値・残差(ズレ)を並べて比較する
comparison = pd.DataFrame({
    'name': input_data['name'],
    'actual': y_score,
    'simple_pred': simple_predicted.round(1),
    'multiple_pred': multiple_predicted.round(1),
    'multiple_residual': (y_score - multiple_predicted).round(1),
})
print('\n=== 実測値と予測値の比較 ===')
print(comparison)

# ------------------------------------------------------------
# 3. 可視化
# ------------------------------------------------------------
fig, axes = plt.subplots(1, 3, figsize=(16, 5))

# (1) 単回帰:散布図に回帰直線を重ねる
# 点が直線の近くに集まっているほど、当てはまりが良いことを表す
axes[0].scatter(x_study, y_score, color='navy', label='actual data')
line_x = np.linspace(x_study.min(), x_study.max(), 100)
axes[0].plot(line_x, slope * line_x + intercept, color='crimson',
             label=f'y = {slope:.2f}x + {intercept:.2f}')
axes[0].set_title(f'Simple Regression (R² = {simple_r2:.3f})')
axes[0].set_xlabel('study_hours')
axes[0].set_ylabel('test_score')
axes[0].legend()
axes[0].grid(True)

# (2) 重回帰:実測値 vs 予測値
# 説明変数が2つ以上だと直線では描けないため、
# 「実測値」と「予測値」を比較する。点が対角線(y = x)上に並ぶほど予測が正確
axes[1].scatter(y_score, multiple_predicted, color='seagreen', label='multiple regression')
axes[1].scatter(y_score, simple_predicted, color='gray', alpha=0.5, label='simple regression')
score_range = [y_score.min(), y_score.max()]
axes[1].plot(score_range, score_range, color='crimson', linestyle='--', label='perfect prediction')
axes[1].set_title(f'Actual vs Predicted (multiple R² = {multiple_r2:.3f})')
axes[1].set_xlabel('actual test_score')
axes[1].set_ylabel('predicted test_score')
axes[1].legend()
axes[1].grid(True)

# (3) 残差プロット:予測値ごとの「ズレ(実測値 - 予測値)」
# 残差が0の線の上下にランダムに散らばっていれば、回帰モデルが妥当と判断できる
# 逆に、曲線状などのパターンが見える場合は、直線のモデルが合っていない可能性がある
axes[2].scatter(multiple_predicted, y_score - multiple_predicted, color='darkorange')
axes[2].axhline(0, color='crimson', linestyle='--')
axes[2].set_title('Residual Plot (multiple regression)')
axes[2].set_xlabel('predicted test_score')
axes[2].set_ylabel('residual (actual - predicted)')
axes[2].grid(True)

plt.tight_layout()
plt.show()
・regression_data.csv
name,study_hours,sleep_hours,test_score
Aoki,1.0,5.5,42
Ito,1.5,7.0,50
Ueda,2.0,6.0,51
Endo,2.5,7.5,60
Ota,3.0,5.0,55
Kato,3.0,8.0,66
Kimura,3.5,6.5,63
Kudo,4.0,7.0,70
Kondo,4.5,5.5,66
Saito,5.0,7.5,79
Sato,5.5,6.0,76
Shimizu,6.0,8.0,88
Suzuki,6.5,6.5,84
Takahashi,7.0,7.0,89
Tanaka,7.5,5.0,82
Nakamura,8.0,7.5,95
■実行結果
コンソール出力
=== 元データ ===
         name  study_hours  sleep_hours  test_score
0        Aoki          1.0          5.5          42
1         Ito          1.5          7.0          50
2        Ueda          2.0          6.0          51
3        Endo          2.5          7.5          60
4         Ota          3.0          5.0          55
5        Kato          3.0          8.0          66
6      Kimura          3.5          6.5          63
7        Kudo          4.0          7.0          70
8       Kondo          4.5          5.5          66
9       Saito          5.0          7.5          79
10       Sato          5.5          6.0          76
11    Shimizu          6.0          8.0          88
12     Suzuki          6.5          6.5          84
13  Takahashi          7.0          7.0          89
14     Tanaka          7.5          5.0          82
15   Nakamura          8.0          7.5          95

=== 単回帰分析(勉強時間 → 点数) ===
回帰式:点数 = 6.894 × 勉強時間 + 39.373
→ 勉強時間が1時間増えると、点数は約 6.89 点上がる
決定係数 R²:0.922
(確認)np.polyfit の結果:傾き = 6.894, 切片 = 39.373
予測:勉強時間 5.25 時間 → 約 75.6 点

=== 重回帰分析(勉強時間 + 睡眠時間 → 点数) ===
回帰式:点数 = 12.576 + 6.682 × 勉強時間 + 4.206 × 睡眠時間
→ 睡眠時間が同じなら、勉強時間1時間で約 6.68 点上がる
→ 勉強時間が同じなら、睡眠時間1時間で約 4.21 点上がる
決定係数 R²:0.993(単回帰:0.922)

=== 実測値と予測値の比較 ===
         name  actual  simple_pred  multiple_pred  multiple_residual
0        Aoki      42         46.3           42.4               -0.4
1         Ito      50         49.7           52.0               -2.0
2        Ueda      51         53.2           51.2               -0.2
3        Endo      60         56.6           60.8               -0.8
4         Ota      55         60.1           53.7                1.3
5        Kato      66         60.1           66.3               -0.3
6      Kimura      63         63.5           63.3               -0.3
7        Kudo      70         66.9           68.7                1.3
8       Kondo      66         70.4           65.8                0.2
9       Saito      79         73.8           77.5                1.5
10       Sato      76         77.3           74.6                1.4
11    Shimizu      88         80.7           86.3                1.7
12     Suzuki      84         84.2           83.3                0.7
13  Takahashi      89         87.6           88.8                0.2
14     Tanaka      82         91.1           83.7               -1.7
15   Nakamura      95         94.5           97.6               -2.6
単回帰分析では「点数 = 6.894 × 勉強時間 + 39.373」という回帰式が得られ、決定係数は 0.922 となった。numpy.polyfit の結果とも一致しており、最小二乗法の計算が正しいことが確認できる。
睡眠時間を説明変数に加えた重回帰分析では、決定係数が 0.922 → 0.993 に向上した。睡眠時間が同じなら勉強時間1時間で約6.68点、勉強時間が同じなら睡眠時間1時間で約4.21点上がる、という結果になった。比較表を見ると、単回帰では大きくズレていた Ota さん(勉強3.0h・睡眠5.0h)や Tanaka さん(勉強7.5h・睡眠5.0h)の予測値が、睡眠時間を考慮した重回帰では実測値に近づいていることがわかる。
グラフ
- 左:単回帰の散布図と回帰直線。点がおおむね直線の周りに集まっているが、ばらつきも残っている
- 中央:実測値 vs 予測値。重回帰(緑)の点は単回帰(灰色)よりも対角線(完全な予測)の近くに並んでいる
- 右:重回帰の残差プロット。残差が0の線の上下にランダムに散らばっており、特定のパターンは見られないため、直線モデルが妥当と判断できる
コメント