■概要
統計・機械学習の前処理でよく使われる「正規化(Normalization)」について、代表的な2つの手法であるMin-Max正規化とZ-score標準化(スタンダーディゼーション)をPythonで実装する。
単位やスケールが異なる複数の数値列(今回は身長cmと体重kg)をそのまま扱うと、値の大きい列が結果に強く影響してしまうことがある。正規化・標準化を行うことで、異なるスケールのデータを同じ基準で比較・分析できるようになる。
- Min-Max正規化:データを「最小値=0, 最大値=1」の範囲に変換する手法(計算式:
(x - 最小値) / (最大値 - 最小値))。値の範囲が必ず[0, 1]に収まるため直感的にわかりやすいが、外れ値があると他のデータが狭い範囲に押し込められ影響を受けやすい - Z-score標準化:データを「平均=0, 標準偏差=1」の分布に変換する手法(計算式:
(x - 平均値) / 標準偏差)。値の範囲は決まっていない(理論上は-∞〜∞)が、外れ値の影響がMin-Max正規化より小さく、機械学習の前処理として広く使われる
■実装するサンプル処理の概要
8人分の身長(height_cm)・体重(weight_kg)のサンプルデータをCSVから読み込み、それぞれの数値列に対してMin-Max正規化とZ-score標準化を適用する。
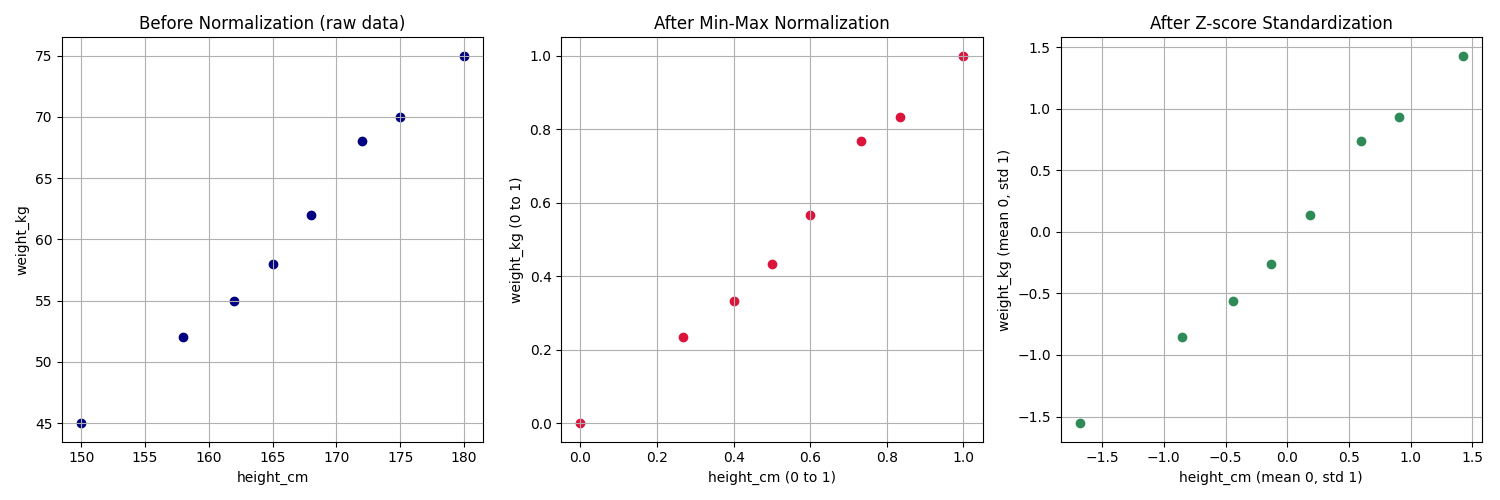
変換前後の値をコンソールに出力して比較できるようにするとともに、「変換前」「Min-Max正規化後」「Z-score標準化後」の3つの散布図を1つの図にまとめて描画し、スケールの違いが可視化でどのように変わるかを確認する。
■フローチャート
以下に今回実装する処理のフローチャートを示す。
flowchart TD
A([開始]) --> B["Min-Max正規化関数 min_max_normalize(series) を定義"]
B --> C["Z-score標準化関数 z_score_standardize(series) を定義"]
C --> D["CSVファイルを読み込む (normalization_data.csv)"]
D --> E["正規化対象の数値列 (height_cm, weight_kg) を指定"]
E --> F["各列にMin-Max正規化を適用 min_max_result を作成"]
F --> G["各列にZ-score標準化を適用 z_score_result を作成"]
G --> H["元データ・Min-Max正規化後・ Z-score標準化後をコンソール出力"]
H --> I[散布図を3つ並べて描画 変換前 / Min-Max / Z-score]
I --> J["グラフを装飾 (タイトル・軸ラベル・グリッド)"]
J --> K[グラフを表示]
K --> L([終了])
処理の流れは以下の通り。
min_max_normalize/z_score_standardizeの2つの変換関数を定義する- CSV(身長・体重データ)を読み込み、対象列(height_cm, weight_kg)を指定する
- 各列にMin-Max正規化・Z-score標準化をそれぞれ適用し、結果を別のDataFrameに格納する
- 元データ・Min-Max正規化後・Z-score標準化後の3つをコンソールに出力して比較する
- 「変換前」「Min-Max正規化後」「Z-score標準化後」の散布図を横に並べて描画し、可視化で違いを確認する
■サンプルコード
以下に今回実装するサンプルコードを示す。
・data_normalization.py
import matplotlib.pyplot as plt
import pandas as pd


def min_max_normalize(series: pd.Series) -> pd.Series:
    """
    Min-Maxノーマライゼーション(正規化)
    データを「最小値=0, 最大値=1」の範囲に変換する手法。

    計算式:(x - 最小値) / (最大値 - 最小値)

    特徴:
    - 値の範囲が必ず [0, 1] に収まるため、直感的にわかりやすい
    - 外れ値(極端に大きい/小さい値)があると、他のデータが
      狭い範囲に押し込められてしまい、影響を受けやすい
    """
    return (series - series.min()) / (series.max() - series.min())


def z_score_standardize(series: pd.Series) -> pd.Series:
    """
    Z-score標準化(スタンダーディゼーション)
    データを「平均=0, 標準偏差=1」の分布に変換する手法。

    計算式:(x - 平均値) / 標準偏差

    特徴:
    - 値の範囲は決まっていない(理論上は -∞〜∞)
    - 外れ値の影響がMin-Max正規化より小さい
    - 機械学習(回帰・SVM・ニューラルネットワークなど)の
      前処理として広く使われる
    """
    return (series - series.mean()) / series.std()


# CSVを読み込む
# 列:name(名前), height_cm(身長cm), weight_kg(体重kg)
# → 単位・スケールが異なる2つの数値列を持つデータ
input_data = pd.read_csv('normalization_data/normalization_data.csv')

# 正規化・標準化を行いたい数値列のみを対象とする
target_columns = ['height_cm', 'weight_kg']

# Min-Max正規化を適用した結果を格納するDataFrame
min_max_result = input_data.copy()
for column in target_columns:
    min_max_result[column] = min_max_normalize(input_data[column])

# Z-score標準化を適用した結果を格納するDataFrame
z_score_result = input_data.copy()
for column in target_columns:
    z_score_result[column] = z_score_standardize(input_data[column])

# 変換前後の値をコンソールに出力して比較できるようにする
print('=== 元データ(スケールがバラバラ) ===')
print(input_data)
print('\n=== Min-Max正規化後(0〜1の範囲に統一) ===')
print(min_max_result)
print('\n=== Z-score標準化後(平均0・標準偏差1に統一) ===')
print(z_score_result)

# 「身長」と「体重」を例に、正規化の前後でスケールがどう変わるかを可視化する
# 正規化前は単位(cmとkg)が違うためスケールが揃わず、
# 正規化後はどちらも同じ基準(0〜1など)で比較できることを確認する
fig, axes = plt.subplots(1, 3, figsize=(15, 5))

axes[0].scatter(input_data['height_cm'], input_data['weight_kg'], color='navy')
axes[0].set_title('Before Normalization (raw data)')
axes[0].set_xlabel('height_cm')
axes[0].set_ylabel('weight_kg')
axes[0].grid(True)

axes[1].scatter(min_max_result['height_cm'], min_max_result['weight_kg'], color='crimson')
axes[1].set_title('After Min-Max Normalization')
axes[1].set_xlabel('height_cm (0 to 1)')
axes[1].set_ylabel('weight_kg (0 to 1)')
axes[1].grid(True)

axes[2].scatter(z_score_result['height_cm'], z_score_result['weight_kg'], color='seagreen')
axes[2].set_title('After Z-score Standardization')
axes[2].set_xlabel('height_cm (mean 0, std 1)')
axes[2].set_ylabel('weight_kg (mean 0, std 1)')
axes[2].grid(True)

plt.tight_layout()
plt.show()
・normalization_data.csv
name,height_cm,weight_kg
Aさん,158,52
Bさん,172,68
Cさん,165,58
Dさん,180,75
Eさん,150,45
Fさん,168,62
Gさん,175,70
Hさん,162,55
■実行結果
上記コードを実行すると、以下のようにコンソールへ出力される。
=== 元データ(スケールがバラバラ) ===
  name  height_cm  weight_kg
0  Aさん        158         52
1  Bさん        172         68
2  Cさん        165         58
3  Dさん        180         75
4  Eさん        150         45
5  Fさん        168         62
6  Gさん        175         70
7  Hさん        162         55

=== Min-Max正規化後(0〜1の範囲に統一) ===
  name  height_cm  weight_kg
0  Aさん   0.266667   0.233333
1  Bさん   0.733333   0.766667
2  Cさん   0.500000   0.433333
3  Dさん   1.000000   1.000000
4  Eさん   0.000000   0.000000
5  Fさん   0.600000   0.566667
6  Gさん   0.833333   0.833333
7  Hさん   0.400000   0.333333

=== Z-score標準化後(平均0・標準偏差1に統一) ===
  name  height_cm  weight_kg
0  Aさん  -0.853847  -0.857689
1  Bさん   0.595106   0.733386
2  Cさん  -0.129371  -0.261036
3  Dさん   1.423079   1.429482
4  Eさん  -1.681820  -1.553784
5  Fさん   0.181119   0.136733
6  Gさん   0.905596   0.932271
7  Hさん  -0.439861  -0.559362
変換前(左)はcmとkgでスケールが異なるため軸のレンジもバラバラだが、Min-Max正規化後(中央)はどちらも0〜1の範囲に、Z-score標準化後(右)はどちらも平均0・標準偏差1を中心とした分布に統一され、身長と体重を同じ基準で比較できるようになっていることが確認できる。
コメント